剂量-反应曲线
规格
| 标签 | 值 |
|---|---|
| 版本 | 4.0.0(更新于 2026-04-10) |
| 开发者 | Labii Inc. |
| 类型 | 章节 |
| 支持配置 | 是 |
概述
剂量-反应关系描述生物系统对不同物质暴露水平的响应:从低剂量时的轻微效应,到高剂量时达到平台。剂量-反应数据分析是药物开发、毒理学研究和生物测定验证的核心。传统方法需要将数据导出到 GraphPad Prism 等外部工具,增加了手动步骤和版本控制风险。Labii 的 Dose Response Curve 小插件将孔板布局设计、原始数据录入、背景扣除、四参数逻辑(4PL)曲线拟合以及 EC50/IC50 报告整合到单个 ELN 章节中。只需点击一次,即可获得可用于发表的 S 形曲线、所有关键药理学参数和完整审计跟踪。
使用场景
- 药物效力筛选 — 在先导化合物识别和优化过程中计算候选化合物的 IC50 或 EC50 值
- 细胞毒性测定 — 确定细胞活力的剂量-反应关系,并为毒理学研究推导 LD50 值
- 酶抑制研究 — 表征一定浓度范围内的抑制剂效力和 Hill 协同性
- 受体结合测定 — 拟合激动剂或拮抗剂响应曲线,并提取结合亲和力参数
- 质量控制 — 通过监控不同批次间 EC50 和 Hill 斜率的一致性来确认检测性能
- 合规工作流程 — 在符合 21 CFR Part 11 的 ELN 中维护可追溯、可供审计的剂量-反应记录
界面
只读视图
只读视图显示已完成的剂量-反应分析,包括包含各数据点的 S 形曲线图、根据重复测量得出的误差线,以及叠加的最佳拟合 4PL 曲线。图表下方的结果表列出每个样品计算得到的 EC50/IC50、Hill 斜率、最小响应、最大响应和 R² 拟合优度值。
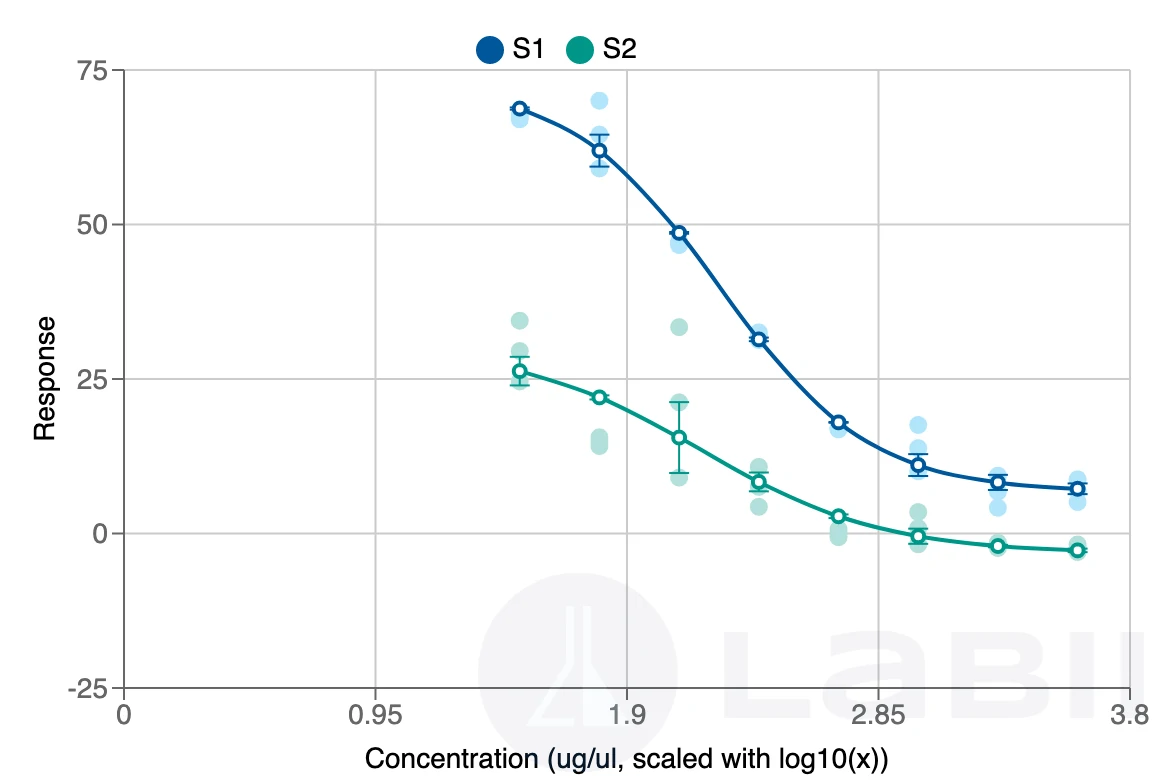
只读视图显示拟合后的 4PL 剂量-反应曲线,以及每个样品的 EC50/IC50、Hill 斜率和最小/最大响应值
编辑视图
编辑视图提供包含 Layout 和 Data 两个输入阶段的 96 孔板界面。在 Layout 阶段,用户通过分配浓度系列、空白、阳性对照和样品标识符来定义孔板布局。在 Data 阶段,用户输入原始响应读数。两个阶段完成后,点击 Analysis 按钮即可运行完整的自动化流程。
配置
点击小插件标题中的 Edit 图标打开配置面板,并调整以下设置。
设置
- Concentration Unit — 图表 X 轴显示的浓度单位标签(例如
ug/ml、nM、uM) - Data Transform — 曲线拟合前应用于响应值的转换:
x— 不转换(原始值)log(x)— 自然对数log10(x)— 以 10 为底的对数10^x— 反对数(x/POSITIVE)*100— 将响应归一化为阳性对照的百分比
- X-Axis Scale — 应用于图表浓度(X)轴的刻度:
x— 线性刻度log(x)— 自然对数刻度log10(x)— Log10 刻度
- Fit Method — 用于拟合剂量-反应曲线的回归模型。默认为
4PL(四参数逻辑) - Fit Settings — 针对每个样品覆盖 Levenberg–Marquardt 拟合算法的初始参数。仅当初始猜测接近真实解时,该算法才会收敛到全局最小值;默认拟合失败时,可使用这些设置提供更合适的起始值。每个条目需要:
- Name — 样品名称,必须与孔板布局中使用的标签完全一致
- Max Iterations — 拟合期间的最大函数调用次数。默认为
1000。值越大,拟合质量越高,但会降低性能 - Hill Slope — 曲线在拐点处陡峭程度的初始猜测。默认为
1 - Minimum — 最小响应值(零剂量时的基线)的初始猜测。默认为
1 - Maximum — 最大响应值(饱和剂量时的平台)的初始猜测。默认为
1 - Inflection Point (EC50/IC50) — 响应达到最大值一半时剂量的初始猜测。默认为
1
对于大多数剂量-反应测定,请为 X 轴刻度使用 log10(x),以生成典型的 S 形曲线。将响应归一化为最大效应百分比时,请使用 (x/POSITIVE)*100 作为数据转换方式。
其他功能
准备布局
此小插件支持 96 孔板。请通过分配孔位角色来定义孔板布局。
点击 Edit Plate 打开孔位编辑器界面
使用以下标签分配孔位角色:
- First cell — 输入浓度单位(例如
ug/ml)作为坐标轴标签 - CONC — 将其放在行标签或列标签中,以沿该行或列定义一系列标准浓度
- BLANK — 将孔标记为空白;系统会计算空白值的平均值并将其作为背景扣除
- POSITIVE — 将孔标记为阳性(上限)对照;选择
(x/POSITIVE)*100转换时,用于百分比归一化 - 其他所有标签均视为样品标识符;重复标签视为重复测量
- 将孔留空可将其排除在分析之外
根据需要点击孔上的 edit 图标,更新其单独的稀释倍数(默认为 1)
也可以直接从 Excel 或 Word 粘贴布局值,或者拖放表格文件以自动导入布局
CONC 必须放在行标签或列标签中,而不能放在数据单元格中,才能沿该行或列正确定义浓度系列。
准备数据
在小插件中切换到 Data 输入模式
从酶标仪输出中复制响应读数,并将其粘贴到相应孔中;也可以手动输入数值
将孔留空可从分析中排除该数据点
执行分析
点击 Analysis 按钮运行完整的自动化流程。分析可在数秒内完成,并按以下顺序执行:
- 计算空白响应平均值 — 计算所有标记为
BLANK的孔的平均值,得到背景值 - 计算阳性对照响应平均值 — 计算所有标记为
POSITIVE的孔的平均值;如果选择百分比归一化,则使用此值 - 背景扣除和数据转换 — 从每个数据点中减去空白平均值,然后应用所选数据转换。转换后的数据可以下载
- 4PL 曲线拟合 — 使用 Levenberg–Marquardt 算法为每个样品拟合四参数逻辑(4PL)模型。系统会显示拟合方程和四个参数:
- Minimum — 零剂量时的基线响应
- Maximum — 饱和剂量时的平台响应
- EC50/IC50 — 拐点处的剂量(半最大效应)
- Hill slope — 曲线在拐点处的陡峭程度
- 曲线图 — 绘制每个数据点、标准误差线(存在重复测量时)以及叠加的最佳拟合 4PL 曲线。X 轴根据所选 X 轴刻度设置进行缩放
仅当初始参数猜测与真实解足够接近时,Levenberg–Marquardt 算法才会收敛到全局最小值。如果某个样品的拟合曲线看起来不正确,请点击该样品上的 edit 图标,调整初始参数值,然后重新运行分析。
最佳实践
- 对样品进行重复测量 — 每个浓度设置双孔或三孔重复,可用于计算标准误差并提高曲线拟合的可靠性
- 每块孔板都应包含空白孔 — 空白孔可确保准确扣除背景;空白读数异常偏高表示试剂或孔板可能受到污染
- 包含阳性对照 — 使用已知饱和浓度的阳性对照,可确认检测性能并支持百分比归一化
- 覆盖足够的浓度范围 — 浓度系列应在预期 EC50/IC50 两侧各至少跨越两个数量级,以完整定义 S 形曲线
- 使用 log10 X 轴刻度 — 对浓度轴应用对数刻度可使曲线中段线性化,并生成典型的 S 形剂量-反应图
- 拟合失败时调整初始参数 — 如果曲线不收敛,请使用每个样品的 edit 图标,将 Minimum、Maximum、EC50 和 Hill slope 的初始猜测设置为接近预期的值
对于 S 形曲线陡峭的检测,Hill 斜率显著大于 1 可能表示存在协同结合或多个结合位点。请标记这类结果,以便进一步研究其机制。
相关小插件
- ELISA 标准曲线 — 拟合线性和非线性标准曲线,以进行定量浓度测定。如果目标是根据标准曲线计算样品浓度,而不是计算药理学参数,请使用此小插件
- 定性 ELISA — 对 ELISA 数据进行二元阳性/阴性分类。如果需要通过/失败结果,而不是连续的剂量-反应关系,请使用此小插件
参考资料
- 剂量-反应关系 — Wikipedia
- 四参数逻辑(4PL)曲线 — AAT Bioquest
- Levenberg–Marquardt 算法 — Wikipedia
- 视频教程 — Dose Response Curve 小插件使用演示
- 21 CFR Part 11 — 电子记录和签名