Chart By Category X
规格
| 标签 | 值 |
|---|---|
| 版本 | 0.1.0(更新于 2025-04-20) |
| 开发者 | Labii Inc. |
| 类型 | 章节 |
| 支持配置 | 是 |
概述
Chart By Category X 小插件根据实验记录和章节中的分类数据生成交互式可视化。它利用 Select 或 ForeignKey 列对数据进行分类,并显示不同类别的记录数或聚合数值,因此非常适合分析分布、比较组别和跟踪趋势。该小插件支持多种聚合方法(总和、平均值、最大值、最小值、中位数)、灵活的坐标轴格式和可选分组功能,可直接在实验室工作流程中将表格数据转化为清晰、可操作的见解。
使用场景
- 样本分布分析:显示样本在不同处理组、细胞系或实验条件中的分布
- 处理比较:比较不同处理类别或实验方案中的数值测量结果,例如浓度、纯度和产量
- 质量控制监控:跟踪不同产品批次或质量类别的测试结果、通过/失败率或检查结果
- 实验进度跟踪:监控项目章节中的任务完成状态、工作流程阶段或里程碑完成情况
- 库存分析:按供应商、位置或类型分类显示试剂用量、库存水平或消耗模式
- 人员工作效率:分析不同团队成员的记录创建、实验完成或任务分配情况
- 设备利用率:跟踪不同设备类别的仪器使用、维护状态或可用性
- 基于时间的分类:使用基于日期的分类列时,显示不同时间段(每周、每月)的数据分布
界面
只读视图
只读视图显示交互式柱状图,x 轴为类别,y 轴为计数或聚合值。可视化位于章节内部,并根据配置设置自动更新。
- 数据显示:使用标签清晰的坐标轴和颜色编码系列,以柱状图显示分类数据
- 交互功能:将鼠标悬停在柱形上,可查看准确数值和类别标签
- 图表交互:如果启用了自动更新,底层数据发生变化时,可视化会动态更新
- 导出入口:提供 Download 按钮,可提取源数据用于外部分析
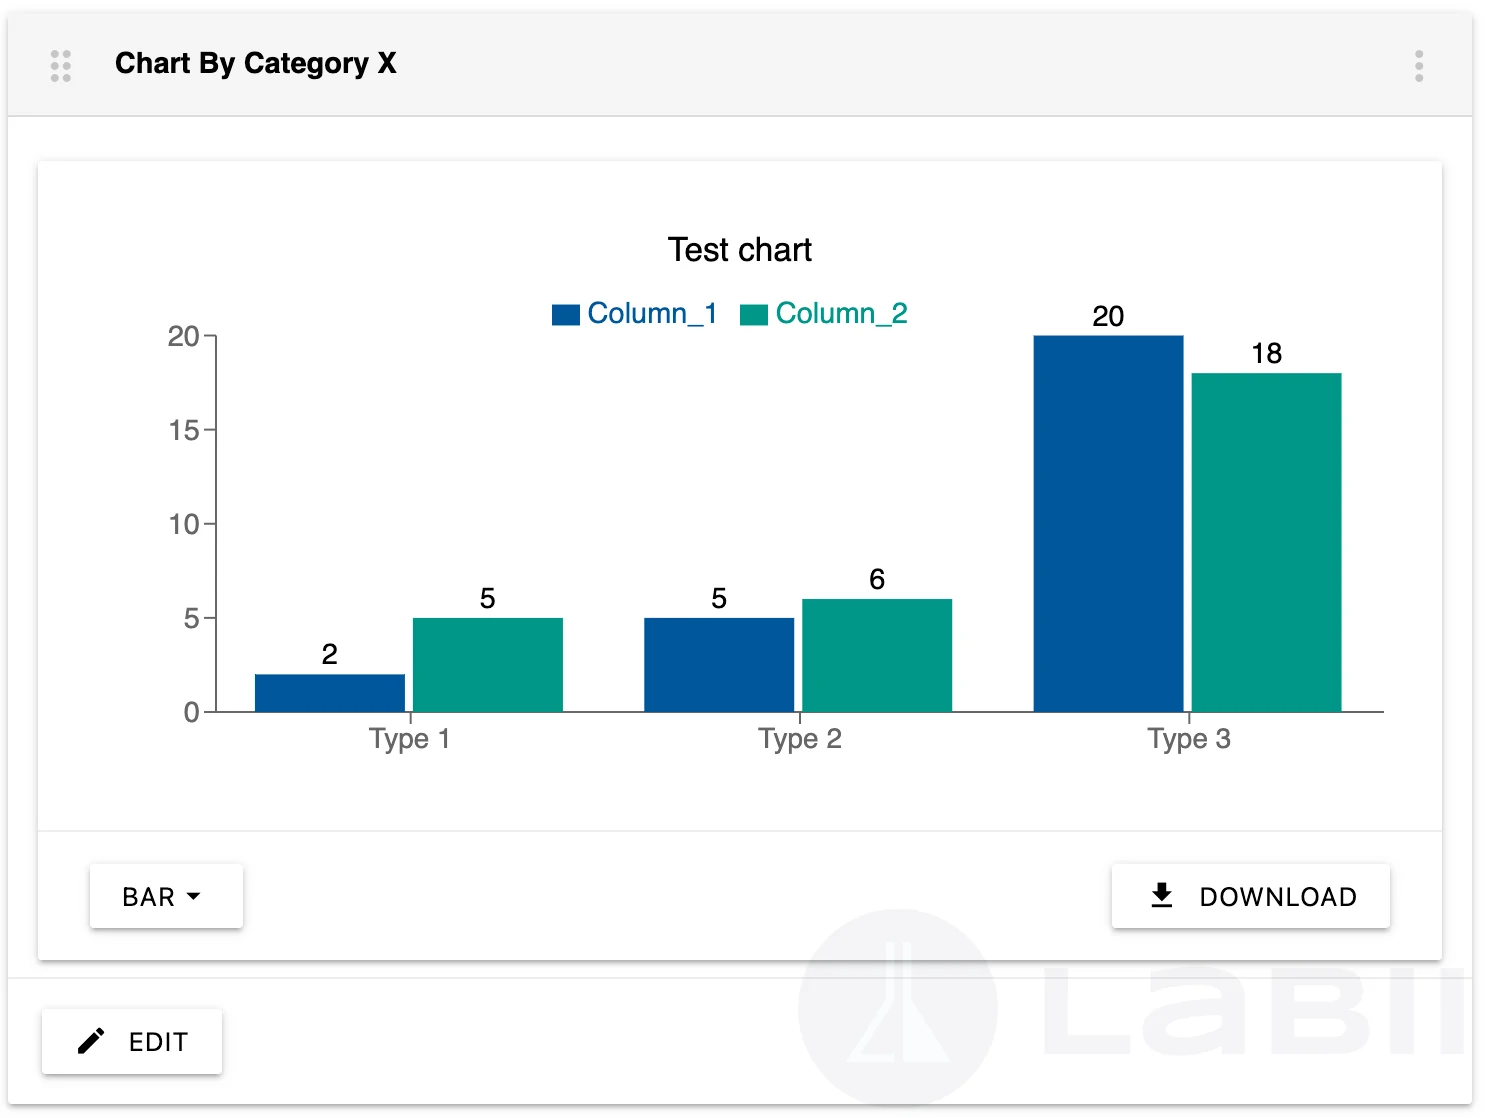
只读视图显示柱状图,x 轴为类别,y 轴为聚合值,清楚呈现数据分布
编辑视图
该小插件专用于数据可视化和报告,因此不提供编辑视图。所有配置和自定义操作都通过小插件标题栏中 Configure 按钮打开的设置面板完成。小插件根据配置参数自动生成可视化,无需直接编辑图表本身。
配置
初始设置
点击 Add Widget,然后从 Data Driven Charts 类别中选择 Chart By Category X,将该小插件添加到章节
点击小插件标题栏中的 Configure 按钮或设置图标,打开配置面板
按照以下说明配置数据源和可视化参数
必需设置
小插件必须配置以下设置才能正常运行:
- Table:选择包含要可视化数据的表格。此选择会更新其他配置选项中的可用列
可选设置
使用以下可选参数自定义可视化:
数据筛选和来源
- Query:输入查询字符串,筛选图表中包含的记录。留空则包含所选表格的所有记录
- X axis:选择用作 x 轴类别的列。Select 或 ForeignKey 列最适合分类数据。如果未选择任何内容,将使用记录名称作为 x 轴
X 轴配置
-
X axis sorting:定义类别在 x 轴上的排列方式
- String (A-Z):按字母升序排列
- String (Z-A):按字母降序排列
- Number (Ascending):按数值升序排列
- Number (Descending):按数值降序排列
- RID (Ascending):按记录 ID 升序排列
- RID (Descending):按记录 ID 降序排列
-
X axis format:控制 ForeignKey 值在 x 轴上的显示方式
- Full (UID: Name):显示完整引用,例如 “TRT24: Untreated Control”
- Name only:仅显示名称部分,例如 “Untreated Control”,并将名称相同的记录归为一组
数据系列和聚合
-
Series:选择一个或多个用作数据系列的列。列必须使用 Number、Formula 或 Consumption 小插件。如果未选择系列,小插件默认显示记录数
-
Group:选择用于创建分组可视化的列。指定组后,x 轴值成为类别,组值成为系列,系列值会针对每种组合进行聚合,从而支持多维分析
-
Data aggregation:定义数值的合并方式
- None:显示原始值,不进行聚合
- Sum:计算所有数值的总和(未选择系列时为默认值)
- Average:计算所有数值的平均值
- Max:显示最大值
- Min:显示最小值
- Median:计算中位数
可视化自定义
- Chart title:为图表提供描述性标题。标题显示在可视化顶部
- Height:以像素设置图表高度,默认为 250px。请根据数据复杂度和章节可用空间调整
自动更新设置
- Should auto update:启用后,在底层数据发生变化时自动重新计算并刷新图表,确保可视化与实验室数据保持最新
- Should auto update when empty:启用后,即使小插件最初没有数据,也会自动执行计算
选择 Table 以定义数据源
选择一个 X axis 列以定义类别,建议使用 Select 或 ForeignKey 列
可以选择一个 Series 列来聚合数值,也可以留空以统计记录数
配置 X axis sorting 和 X axis format,控制类别显示方式
如果使用数值系列,请选择 Data aggregation 方法
添加 Chart title,并根据需要调整 Height
如果需要实时更新图表,请启用 Should auto update
点击 Save 应用配置
小插件需要至少一个使用 Select 或 ForeignKey 小插件的列来提供分类数据。进行数值聚合时,还需要使用 Number、Formula 或 Consumption 小插件的列。
高级配置
对于复杂分析场景:
使用 Group 选项创建包含类别、组和聚合系列的多维可视化
结合 Query 筛选器和 X axis 选择,将分析集中于特定数据子集
处理名称相同但 ID 不同的 ForeignKey 引用时,将 X axis format 设置为 “Name only”
尝试不同的 Data aggregation 方法,从数据中发现不同见解
包含许多类别、组或大型数据集的复杂配置可能影响图表渲染性能。如果出现性能问题,请考虑使用 Query 筛选器限制数据范围。
其他功能
数据导出
导出用于生成图表的底层数据,以进行外部分析或记录保存:
找到小插件界面中的 Download 按钮,它通常位于小插件标题栏中或图表下方
点击 Download 导出聚合数据
将下载的文件保存到所需位置
导出的数据包括:
- x 轴类别值
- 每个类别的聚合值或计数值
- 配置分组时的组信息
- 选择多个系列时的系列数据
导出的数据可用于:
- 导入外部分析工具,例如 Excel、R、Python 和 GraphPad
- 创建自定义报告和演示文稿
- 为合规文档存档分析结果
- 与需要原始数据的相关人员分享见解
自动更新功能
Chart By Category X 小插件支持自动刷新图表,使可视化与不断变化的数据保持同步:
在小插件配置中启用 Should auto update
小插件会监控源表格中的更改
添加、修改或删除数据时,图表会自动重新计算并刷新
无需手动操作即可查看更新后的可视化
自动更新特别适合监控正在进行的实验、跟踪实时进度或显示实时质量控制指标。
空值时自动更新:启用 Should auto update when empty 后,即使将小插件首次添加到没有初始数据的章节,也会自动填充图表。这适合将随时间收集数据的模板章节。
灵活的图表类型
默认可视化为柱状图,但底层数据结构支持多种图表形式:
- 柱状图:最适合比较离散类别
- 分组柱状图:使用 Group 选项进行多维比较
- 堆叠可视化:适用于代表整体组成部分的多个系列
小插件会根据配置自动选择最适合的可视化。
最佳实践
数据组织
- 分类清晰:使用具有清晰描述性类别名称的 Select 或 ForeignKey 列,以获得最佳 x 轴标签
- 分类一致:确保各记录中的分类数据标准一致,避免可视化碎片化
- 限制类别数量:为保证可读性,x 轴类别尽量保持在 5–15 个。如果类别过多,请使用 Query 筛选器缩小范围
- 有意义的分组:使用 Group 选项时,选择具有分析价值且不会造成过度复杂的分组列
性能优化
- 查询筛选:应用 Query 筛选器限制记录并提高图表渲染速度,尤其适用于大型数据集
- 有选择地自动更新:仅在实时数据至关重要的章节中使用自动更新,因为它会消耗额外资源
- 优化高度:根据类别数量设置适当的图表高度,确保可读性并避免过多滚动
- 选择聚合方式:为数据类型选择最合适的聚合方法,确保结果有意义
分析策略
- 从简单开始:先统计记录数,再添加数值系列和复杂聚合
- 逐步增强:逐步添加分组和多个系列,以了解数据关系
- 适当聚合:使聚合方法与分析目标匹配,例如总量使用 sum、典型值使用 average、范围使用 max/min
- 排序策略:使用有意义的 x 轴排序,例如名称按字母顺序、时间顺序按 RID
对于处理比较实验,请使用 Group 选项显示不同处理类别中的多次测量(重复实验),并将聚合方式设为 Average,以获得典型响应值。
应避免的常见问题
- 避免:为 x 轴选择文本或富文本列,因为这可能产生杂乱或无意义的类别
- 正确做法:使用专为分类数据设计的 Select 或 ForeignKey 列
- 避免:不了解 “Name only” 会将名称相同的不同记录归为一组,就使用该 x 轴格式
- 正确做法:需要区分记录时使用 “Full (UID: Name)”;只有需要有意分组时才使用 “Name only”
- 避免:在单个图表中显示过多类别(20 个以上)
- 正确做法:应用 Query 筛选器聚焦相关子集,或为不同类别组创建多个图表
可视化最佳实践
- 标题清晰:提供描述性图表标题,说明所显示的数据和聚合方法
- 高度适当:根据类别数量调整图表高度;类别越多,需要的垂直空间越大
- 排序合理:以有助于理解的方式排列类别,例如比较名称时按字母排序,显示时间趋势时按 RID 排序
- 颜色编码:使用组或多个系列时,确保生成的颜色编码易于区分
相关小插件
补充小插件
- Chart By Numeric X:同时需要分类和数值 x 轴可视化时配合使用。Chart By Category X 处理离散组,Chart By Numeric X 显示连续数值关系
- Data Visualizer:需要使用手动输入的汇总数据补充表格驱动图表时,与 Data Visualizer 结合使用
- Record Summary:适合与 Record Summary 小插件并列使用,同时提供高级记录模式分析和详细分类明细
集成场景
- 结合 Chart By Category X、Filter 小插件和表格视图,从可视化和表格两个角度全面探索数据
- 将 Chart By Category X 与 Select 列和 Number 列结合,在实验方案中创建处理响应可视化
- 结合 Chart By Category X、Auto-update 和实时数据输入,为生产环境创建实时质量控制仪表板
- 将 Chart By Category X 与 ForeignKey 列和跨表关系配合使用,分析相关表格中的分布式数据